Krytyczny alert a zwykłe ostrzeżenie
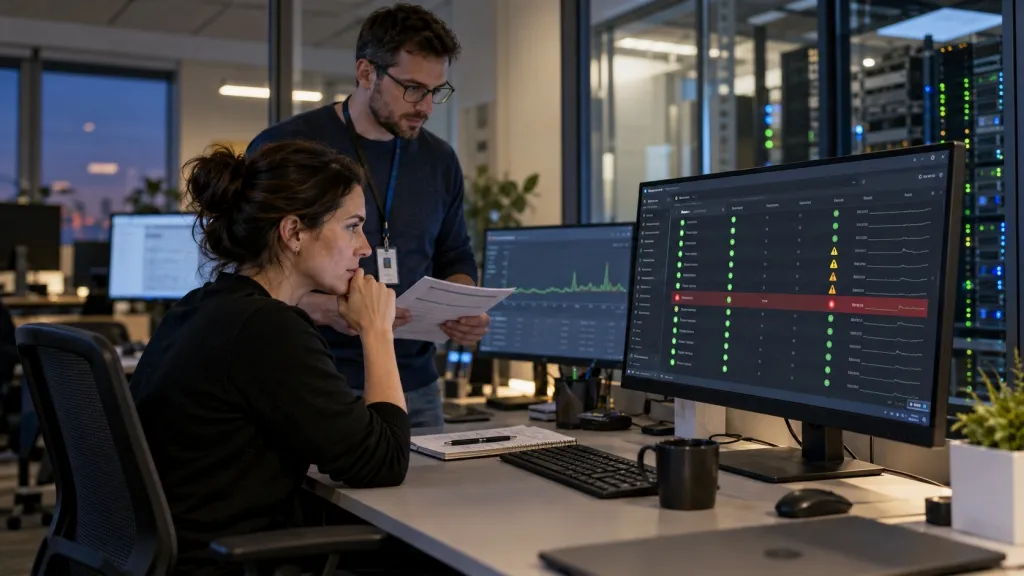
Powiadomienia pochodzące z monitoringu IT różnią się poziomem ważności oraz potencjalnymi konsekwencjami dla działania infrastruktury. Ich właściwa klasyfikacja pozwala administratorom odróżnić problemy wymagające obserwacji od sytuacji, w których konieczna jest pilna interwencja. Na potrzeby oceny pilności reakcji warto rozróżnić dwa podstawowe rodzaje powiadomień:
- Zwykłe ostrzeżenie (warning) – informuje o odchyleniu od ustalonych parametrów pracy, które nie musi jeszcze oznaczać bezpośredniego zagrożenia dla dostępności usług. Może dotyczyć chwilowego wzrostu obciążenia procesora, zwiększonego wykorzystania pamięci RAM lub stopniowego zmniejszania się wolnej przestrzeni dyskowej. Tego rodzaju komunikat wymaga przede wszystkim obserwacji i analizy, które pozwalają ustalić, czy nieprawidłowość ma charakter przejściowy, czy może prowadzić do poważniejszych problemów.
- Krytyczny alert (critical) – wskazuje na nieprawidłowość, która już powoduje lub w krótkim czasie może doprowadzić do poważnych zakłóceń w działaniu infrastruktury IT. Przykładem jest niedostępność kluczowej usługi, awaria ważnego urządzenia sieciowego, utrata dostępu do danych lub uszkodzenie komponentu niezbędnego do zachowania ciągłości pracy systemów. Takie powiadomienia wymagają pilnej weryfikacji, a w przypadku potwierdzenia zagrożenia również niezwłocznej interwencji serwisowej
Alerty o niedostępności usług IT
Do najważniejszych alertów monitoringu IT należą powiadomienia o problemach z dostępnością usług wykorzystywanych w codziennej pracy przedsiębiorstwa. Mogą one dotyczyć systemów ERP, baz danych, aplikacji internetowych lub usług uwierzytelniania. Szczególnej uwagi wymagają powtarzające się błędy połączenia, wydłużony czas odpowiedzi oraz niedostępność potwierdzona kilkoma niezależnymi testami. Priorytet takiego alertu powinien zależeć przede wszystkim od znaczenia danej usługi dla funkcjonowania firmy. Przykładowo brak dostępu do produkcyjnej bazy danych stanowi zwykle większe zagrożenie niż chwilowa niedostępność środowiska testowego. Weryfikacja alarmu powinna obejmować sprawdzenie, czy jego źródłem nie są zakłócenia łączności lub błędy mechanizmu pomiarowego, przy czym w sytuacjach krytycznych diagnostykę należy prowadzić równolegle z zabezpieczaniem zagrożonych usług. W rozpoznawaniu takich zależności pomaga profesjonalny monitoring środowiska IT, który umożliwia wykrywanie nieprawidłowości i ułatwia identyfikację ich źródeł.
„O krytyczności alertu IT decyduje nie tylko rodzaj błędu, ale przede wszystkim jego rzeczywisty lub potencjalny wpływ na dostępność kluczowych usług firmowych.”
Kiedy obciążenie serwera staje się krytyczne?
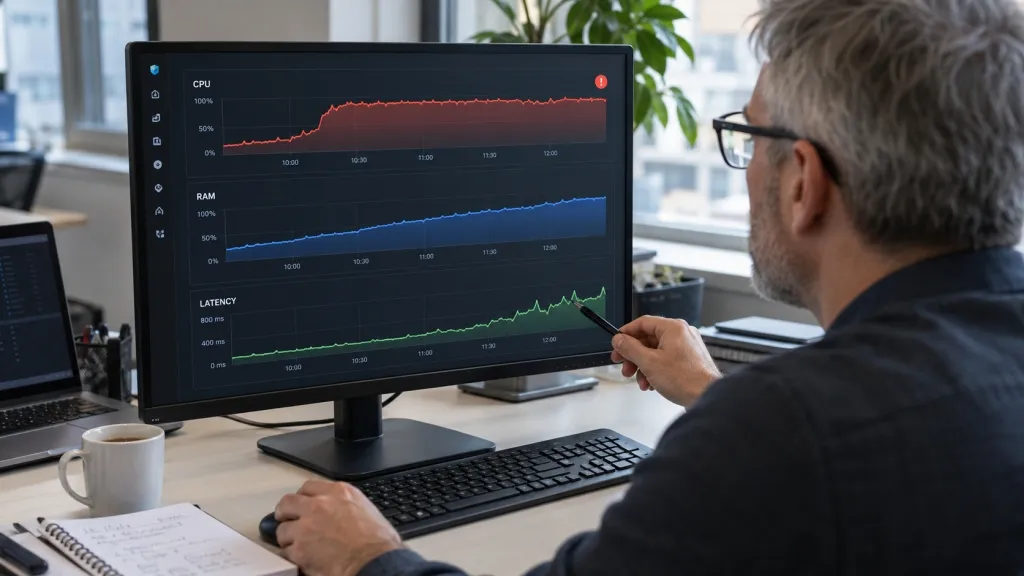
Alerty dotyczące wykorzystania procesora, pamięci RAM i przestrzeni dyskowej należy interpretować z uwzględnieniem specyfiki pracy serwera. Chwilowy wzrost wykorzystania CPU do 90% nie musi oznaczać zagrożenia – zwłaszcza podczas przetwarzania dużych ilości danych lub realizacji zaplanowanych zadań. Problem pojawia się wtedy, gdy wysokie obciążenie utrzymuje się przez dłuższy czas i zaczyna spowalniać działanie aplikacji. Szczególną uwagę należy zwrócić również na powiadomienia o niewystarczającej ilości wolnego miejsca na dysku, błędach alokacji pamięci lub problemach z zapisem danych. Takie nieprawidłowości mogą prowadzić do zakłóceń w działaniu systemów firmowych i utrudniać codzienną pracę użytkowników. O przeciążeniu serwera mogą świadczyć także rosnące opóźnienia operacji dyskowych – nawet przy stosunkowo niewielkim wykorzystaniu procesora. Dlatego ocena poziomu zagrożenia powinna uwzględniać nie tylko bieżące parametry serwera, ale również czas utrzymywania się nieprawidłowości, tempo ich narastania oraz dane z wcześniejszych pomiarów.
Krytyczne alerty systemów pamięci masowej
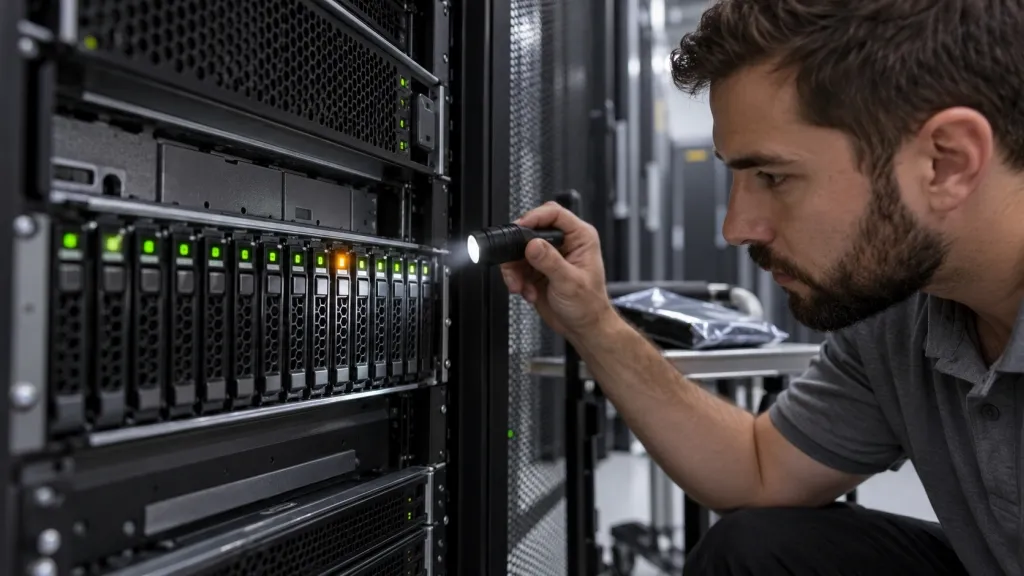
Alerty generowane przez macierze dyskowe i kontrolery RAID mogą sygnalizować zagrożenia dla dostępności oraz integralności firmowych danych. Szczególnej uwagi wymagają błędy odczytu i zapisu, uszkodzenia dysków, utrata dostępu do wolumenów oraz przejście grupy RAID w stan zdegradowany. Awaria pojedynczego dysku nie zawsze oznacza utratę danych, ponieważ odpowiednio skonfigurowane mechanizmy redundancji mogą zapewnić dalszą pracę systemu. Nie należy jednak zwlekać z diagnostyką, zwłaszcza gdy kolejna usterka mogłaby doprowadzić do niedostępności zasobów. Warto również kontrolować przebieg odbudowy macierzy po wymianie uszkodzonego dysku. Istotne są także komunikaty dotyczące awarii kontrolerów, błędów replikacji oraz zakłóceń w komunikacji między serwerami a macierzami. Rozpoznanie przyczyn takich nieprawidłowości może wymagać specjalistycznego serwisu infrastruktury storage i SAN, który pozwala zdiagnozować problemy sprzętowe i konfiguracyjne.
Które alerty sieciowe wymagają interwencji?
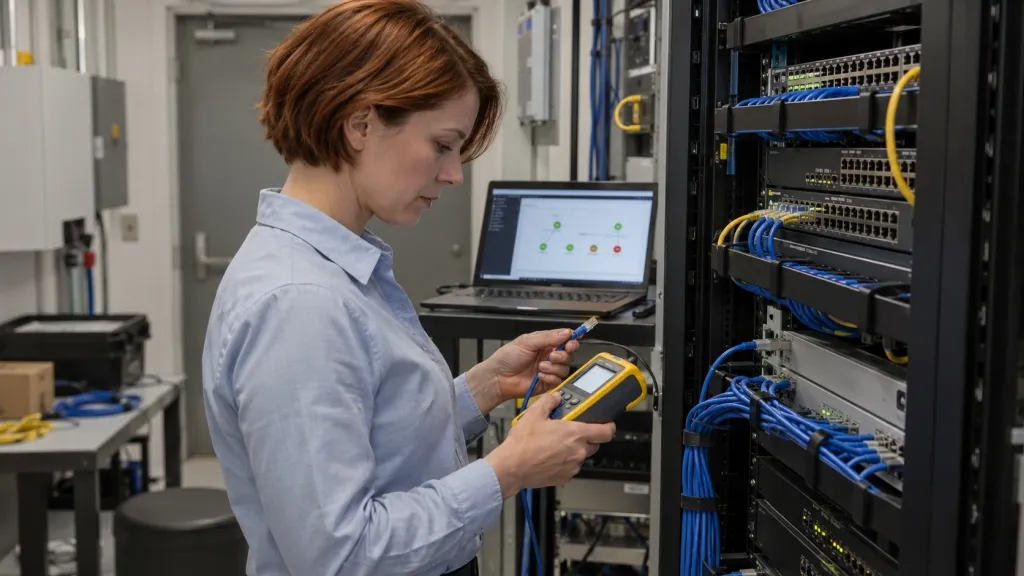
Alerty dotyczące problemów z siecią firmową należy oceniać przede wszystkim pod kątem znaczenia poszczególnych urządzeń i połączeń dla funkcjonowania przedsiębiorstwa. Utrata łączności z jednym stanowiskiem pracy ma zazwyczaj mniejsze konsekwencje niż awaria przełącznika centralnego lub routera odpowiadającego za komunikację między oddziałami. Szczególnej uwagi wymagają powtarzające się zmiany stanu interfejsów sieciowych, wysoki poziom utraty pakietów oraz gwałtowny wzrost opóźnień transmisji. Takie sygnały nie zawsze oznaczają jednak uszkodzenie sprzętu. Ich przyczyną mogą być również błędy konfiguracji, przeciążenia sieci lub nieprawidłowe działanie usług sieciowych. Dlatego podczas diagnostyki warto przeanalizować powiązane komunikaty i sprawdzić dostępność najważniejszych zasobów, nie opóźniając przy tym działań niezbędnych do ograniczenia skutków poważnej awarii. W bardziej rozbudowanych środowiskach wsparciem może być profesjonalny serwis infrastruktury sieciowej LAN i WLAN, który pomaga diagnozować źródła problemów i skutecznie usuwać wykryte nieprawidłowości.
Krytyczne alerty zasilania i chłodzenia
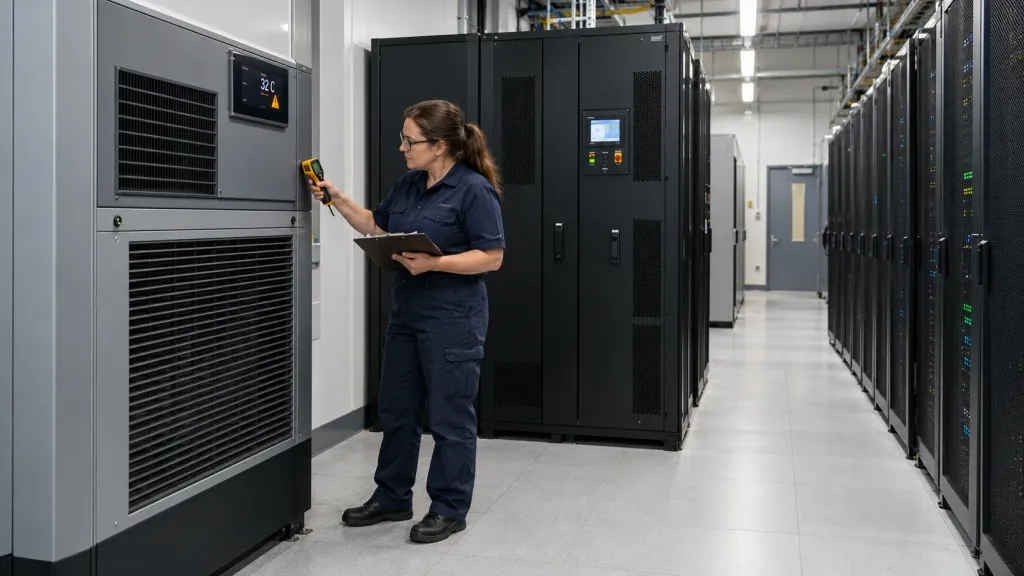
Krytyczne alerty monitoringu IT mogą również sygnalizować nieprawidłowości związane z warunkami pracy urządzeń informatycznych. Utrata zasilania podstawowego, przełączenie UPS na tryb bateryjny, awaria systemu chłodzenia lub gwałtowny wzrost temperatury w szafie serwerowej to sytuacje wymagające pilnej weryfikacji. Szczególne zagrożenie występuje wtedy, gdy przewidywany czas podtrzymania zasilania jest krótszy niż czas potrzebny do bezpiecznego wyłączenia systemów. Niepokojącym sygnałem są także częste przełączenia UPS na pracę bateryjną, które mogą świadczyć o niestabilności zasilania podstawowego. W przypadku alertów temperaturowych należy uwzględnić nie tylko bieżący odczyt, ale również tempo wzrostu temperatury oraz dopuszczalne warunki pracy urządzeń. Istotne jest także porównywanie wskazań kilku czujników, ponieważ temperatura pomieszczenia nie zawsze odpowiada tej panującej bezpośrednio przy wlotach powietrza chłodzącego serwery. Wczesne rozpoznanie takich nieprawidłowości pozwala ograniczyć ryzyko uszkodzenia sprzętu i nieplanowanych przerw w działaniu infrastruktury IT.
Kiedy nieudany backup staje się zagrożeniem?
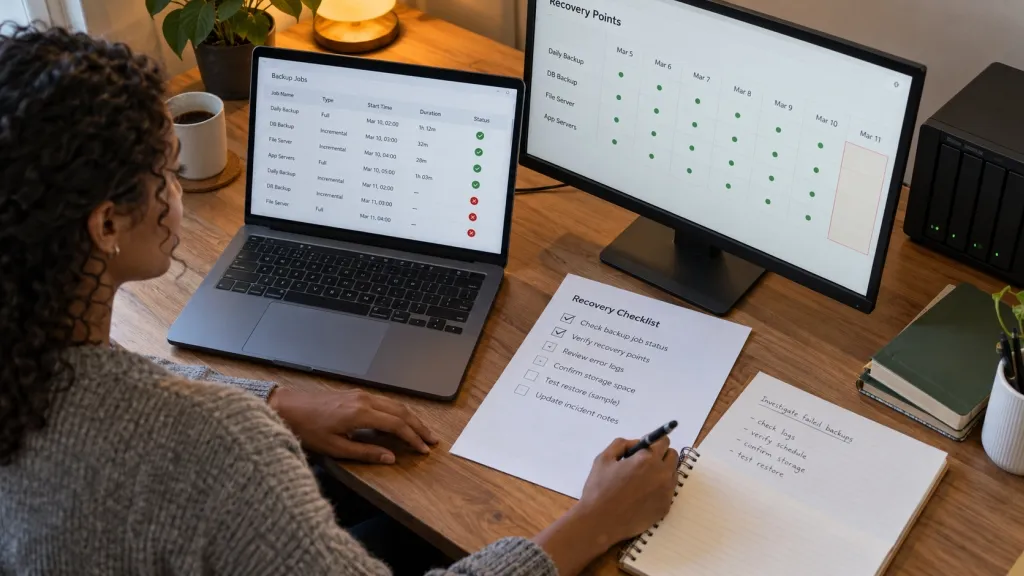
Nieudane wykonanie kopii zapasowej nie powoduje zwykle natychmiastowych zakłóceń w działaniu systemów, ale może znacząco zwiększyć ryzyko utraty danych firmowych. Szczególnej uwagi wymagają alerty informujące o kolejnych nieudanych zadaniach backupu, braku wolnego miejsca w repozytorium, problemach z replikacją oraz niedostępności zasobów docelowych. O pilności reakcji powinien decydować przede wszystkim czas, jaki upłynął od ostatniej poprawnie wykonanej kopii, oraz dopuszczalny poziom utraty danych określony przez parametr RPO (Recovery Point Objective). Nawet pojedynczy błąd może wymagać szybkiej interwencji, jeżeli kolejna zaplanowana próba wykonania backupu nastąpi zbyt późno. Ważne jest również ustalenie, czy problem dotyczy pojedynczych plików, czy całych systemów objętych ochroną. Należy przy tym pamiętać, że pomyślne zakończenie procesu tworzenia kopii zapasowej nie gwarantuje możliwości prawidłowego odtworzenia wszystkich danych. Dlatego tak ważne są regularne testy przywracania oraz właściwe utrzymanie infrastruktury backup, które pomagają ograniczyć ryzyko problemów z przywracaniem danych po awarii.
Dlaczego nie każdy alert wymaga interwencji?
Nadmierna liczba powiadomień z systemów monitoringu IT może utrudniać rozpoznawanie rzeczywistych zagrożeń i opóźniać reakcję na poważne incydenty. Zjawisko określane jako alert fatigue, czyli zmęczenie nadmiarem alertów, występuje między innymi wtedy, gdy progi alarmowe są ustawione zbyt restrykcyjnie lub system generuje wiele komunikatów dotyczących tego samego problemu. Przykładowo chwilowy wzrost obciążenia procesora podczas nocnego przetwarzania danych nie musi oznaczać nieprawidłowości wymagającej interwencji. Samo przekroczenie ustalonej wartości granicznej nie jest więc wystarczającą podstawą do uznania alertu za krytyczny. Przy jego ocenie należy uwzględnić czas trwania problemu, częstotliwość występowania oraz rzeczywisty wpływ na dostępność i wydajność usług. Istotne jest również dostosowanie progów alarmowych do charakterystyki pracy poszczególnych urządzeń i systemów, ponieważ ich typowe obciążenie może znacząco się różnić. Pomocne są także mechanizmy grupowania powiązanych zdarzeń oraz uwzględnianie zaplanowanych prac serwisowych. Odpowiednio skonfigurowane reguły monitoringu pozwalają ograniczyć liczbę zbędnych powiadomień, zachowując jednocześnie skuteczność wykrywania zagrożeń wymagających pilnej reakcji.
Co decyduje o pilności reakcji na alert?
Po otrzymaniu alertu z systemu monitoringu IT należy w pierwszej kolejności ustalić, jakiego zasobu dotyczy problem, jak długo się utrzymuje oraz czy wpływa na działanie pozostałych elementów infrastruktury. Ważne jest również sprawdzenie, czy nieprawidłowość się nasila i czy dostępne mechanizmy redundancji pozwalają zachować ciągłość pracy systemów. Najwyższy priorytet powinny mieć zdarzenia prowadzące do niedostępności kluczowych usług, stwarzające bezpośrednie zagrożenie utratą danych lub mogące doprowadzić do poważnej awarii. Pozostałe powiadomienia warto klasyfikować na podstawie ich rzeczywistych lub przewidywanych konsekwencji, a nie jedynie poziomu ważności przypisanego przez narzędzie monitorujące. Przy ocenie sytuacji należy także uwzględnić liczbę użytkowników dotkniętych problemem oraz przewidywany czas przywrócenia prawidłowego działania usług. Istotne jest również dokumentowanie przebiegu incydentu, wykonanych czynności i wyników diagnostyki. Skuteczne rozpoznawanie krytycznych alertów monitoringu IT wymaga bowiem zestawienia danych technicznych z oceną ich znaczenia dla działalności przedsiębiorstwa. Takie podejście ułatwia szybką reakcję na rzeczywiste zagrożenia, usprawnia organizację pracy zespołu serwisowego i pozwala uniknąć zbędnych interwencji przy mniej istotnych ostrzeżeniach.